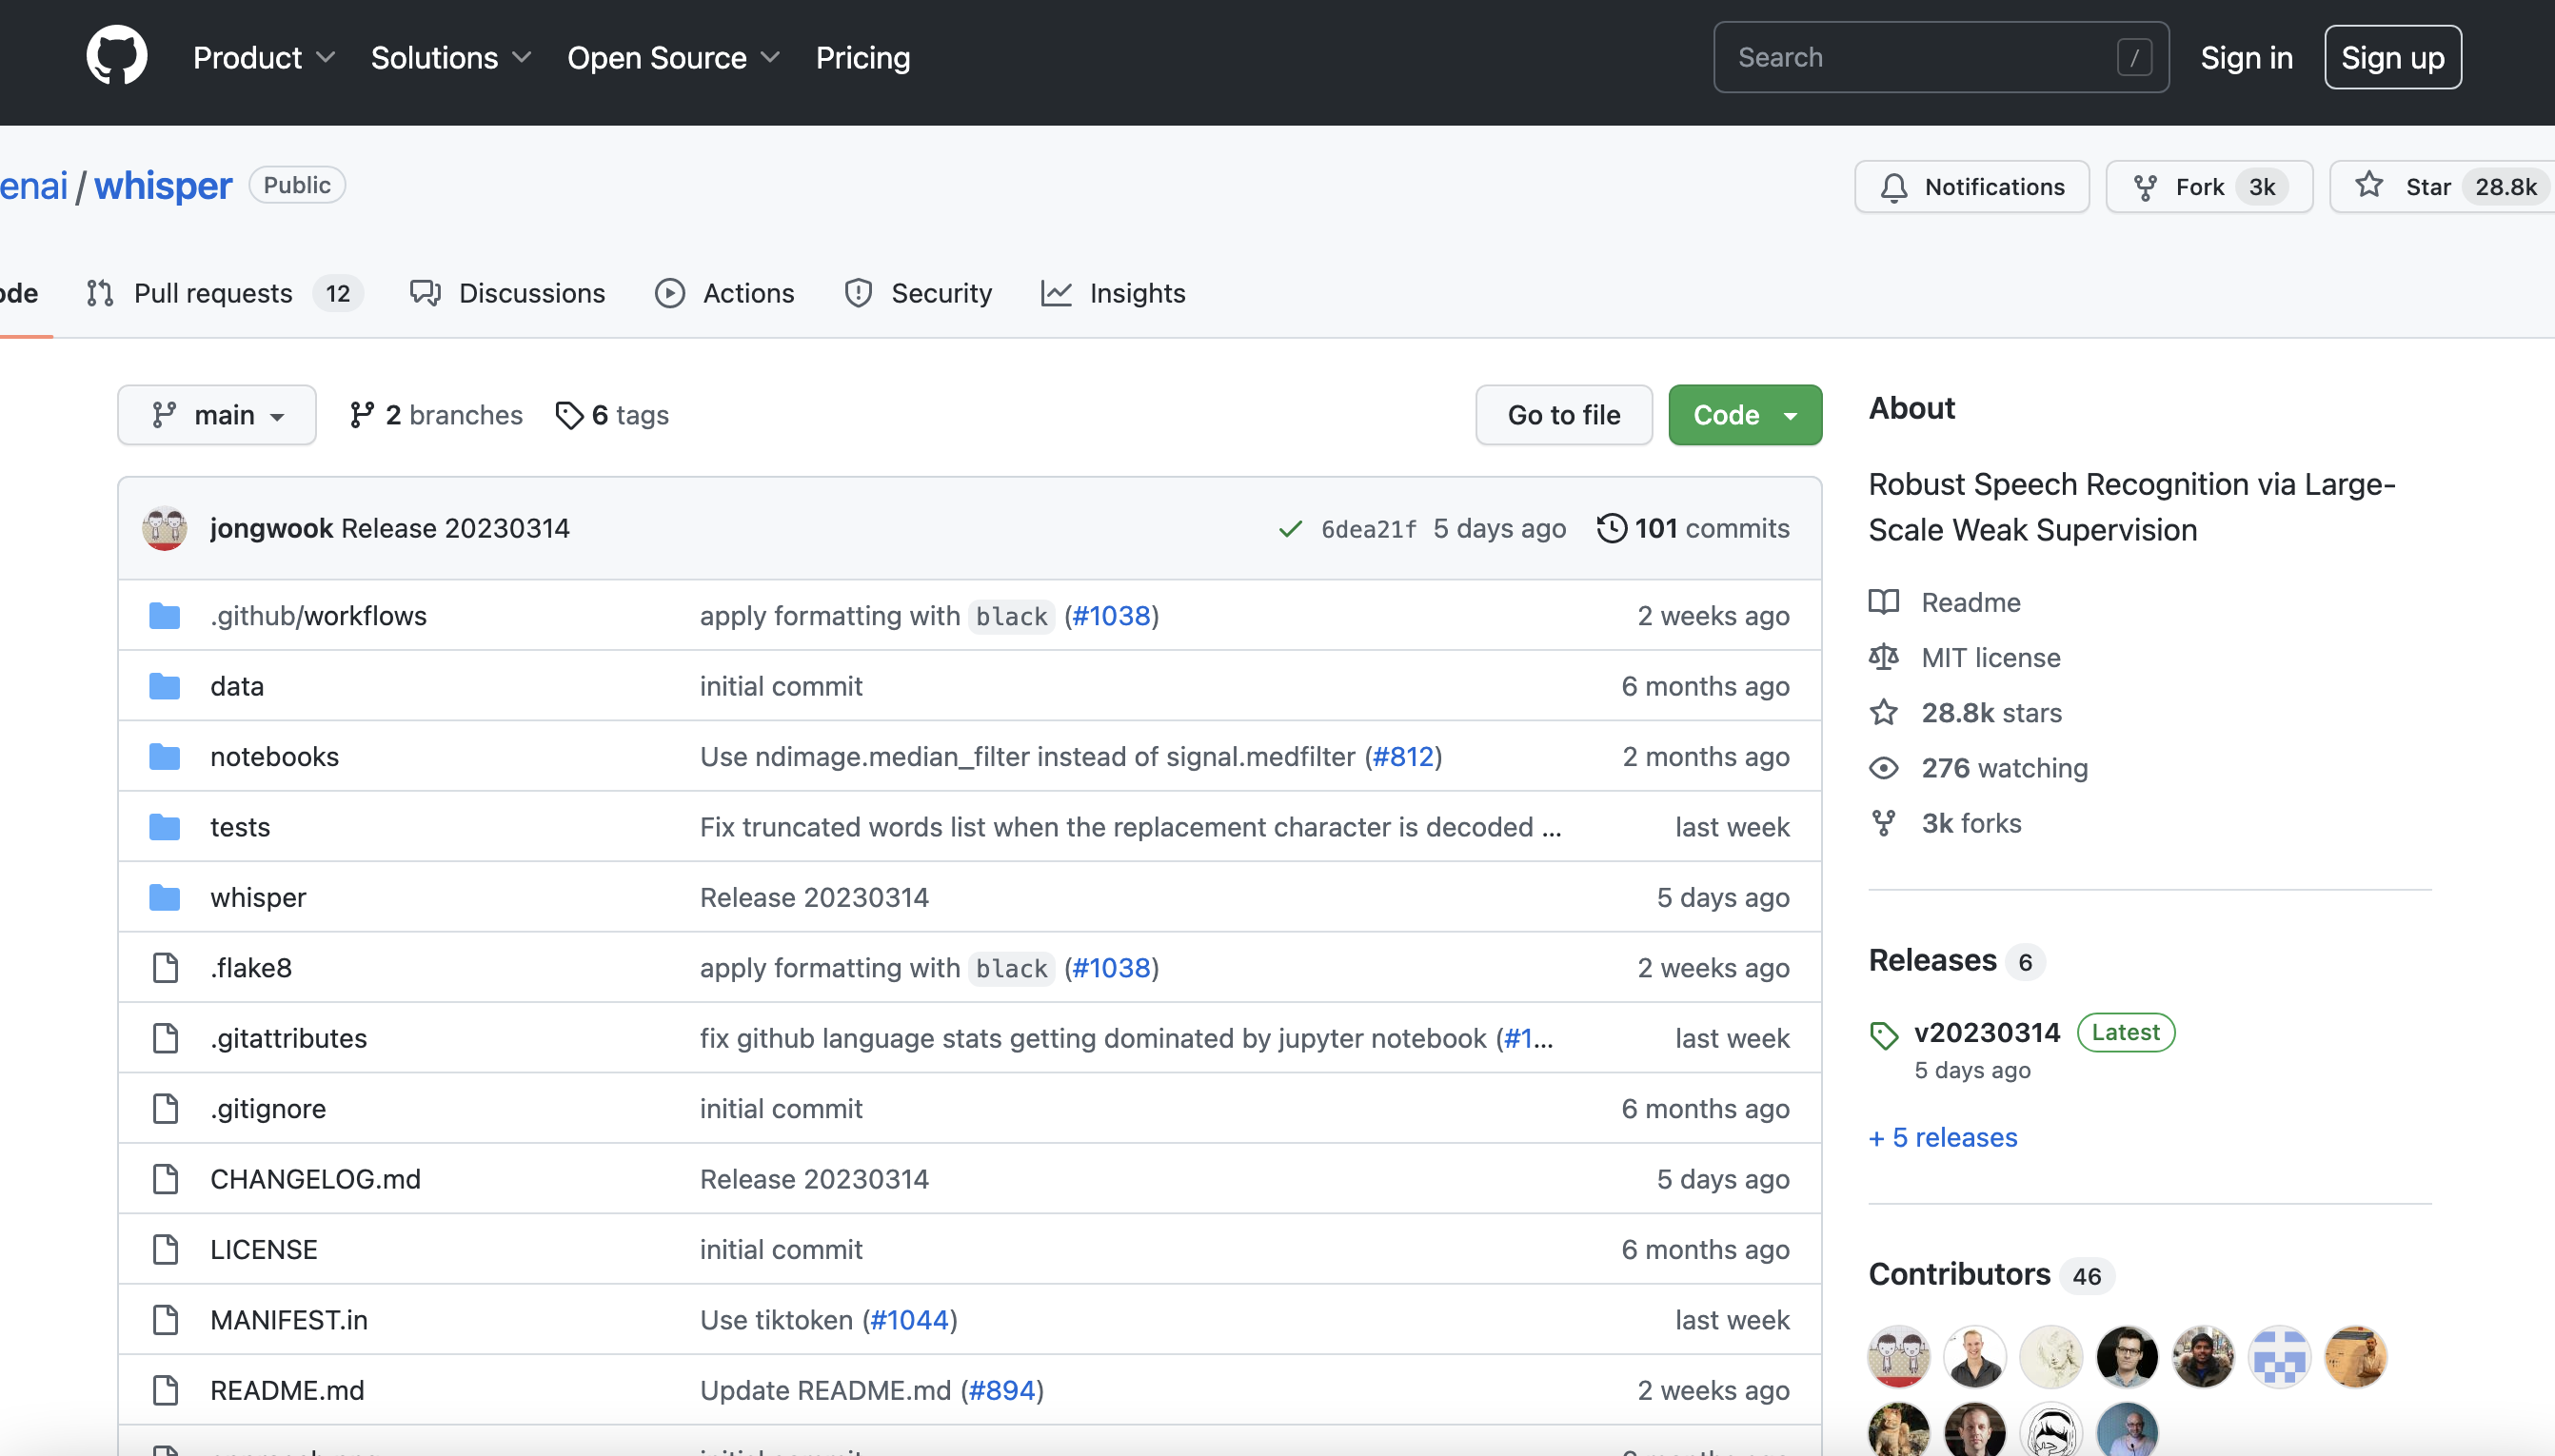
Whisper是由OpenAI开发的一款通用语音识别模型。它训练于一个大型的多样化音频数据集,并且是一种多任务模型,可以执行多语言语音识别、语音翻译和语言识别。Whisper采用了Transformer序列到序列模型,训练于各种语音处理任务,包括多语言语音识别、语音翻译、口语语言识别和语音活动检测。这些任务被作为一串由解码器预测的标记共同表示,使得单一模型能够取代传统语音处理流程中的多个阶段。多任务训练格式使用了一组特殊标记,作为任务说明符或分类目标。
适合人群
- 研究人员
- 开发者
- 数据科学家
- 语言学家
- 记者
- 内容创作者
产品优势
- 高准确性的语音识别
- 支持多种语言
- 可以进行语音翻译
- 同时支持命令行和Python的使用
- 开源且免费使用(MIT许可证)
使用注意
- 需要安装ffmpeg
- 在某些平台上可能需要安装Rust
- 性能因语言而异
- 较大的模型需要显著的VRAM