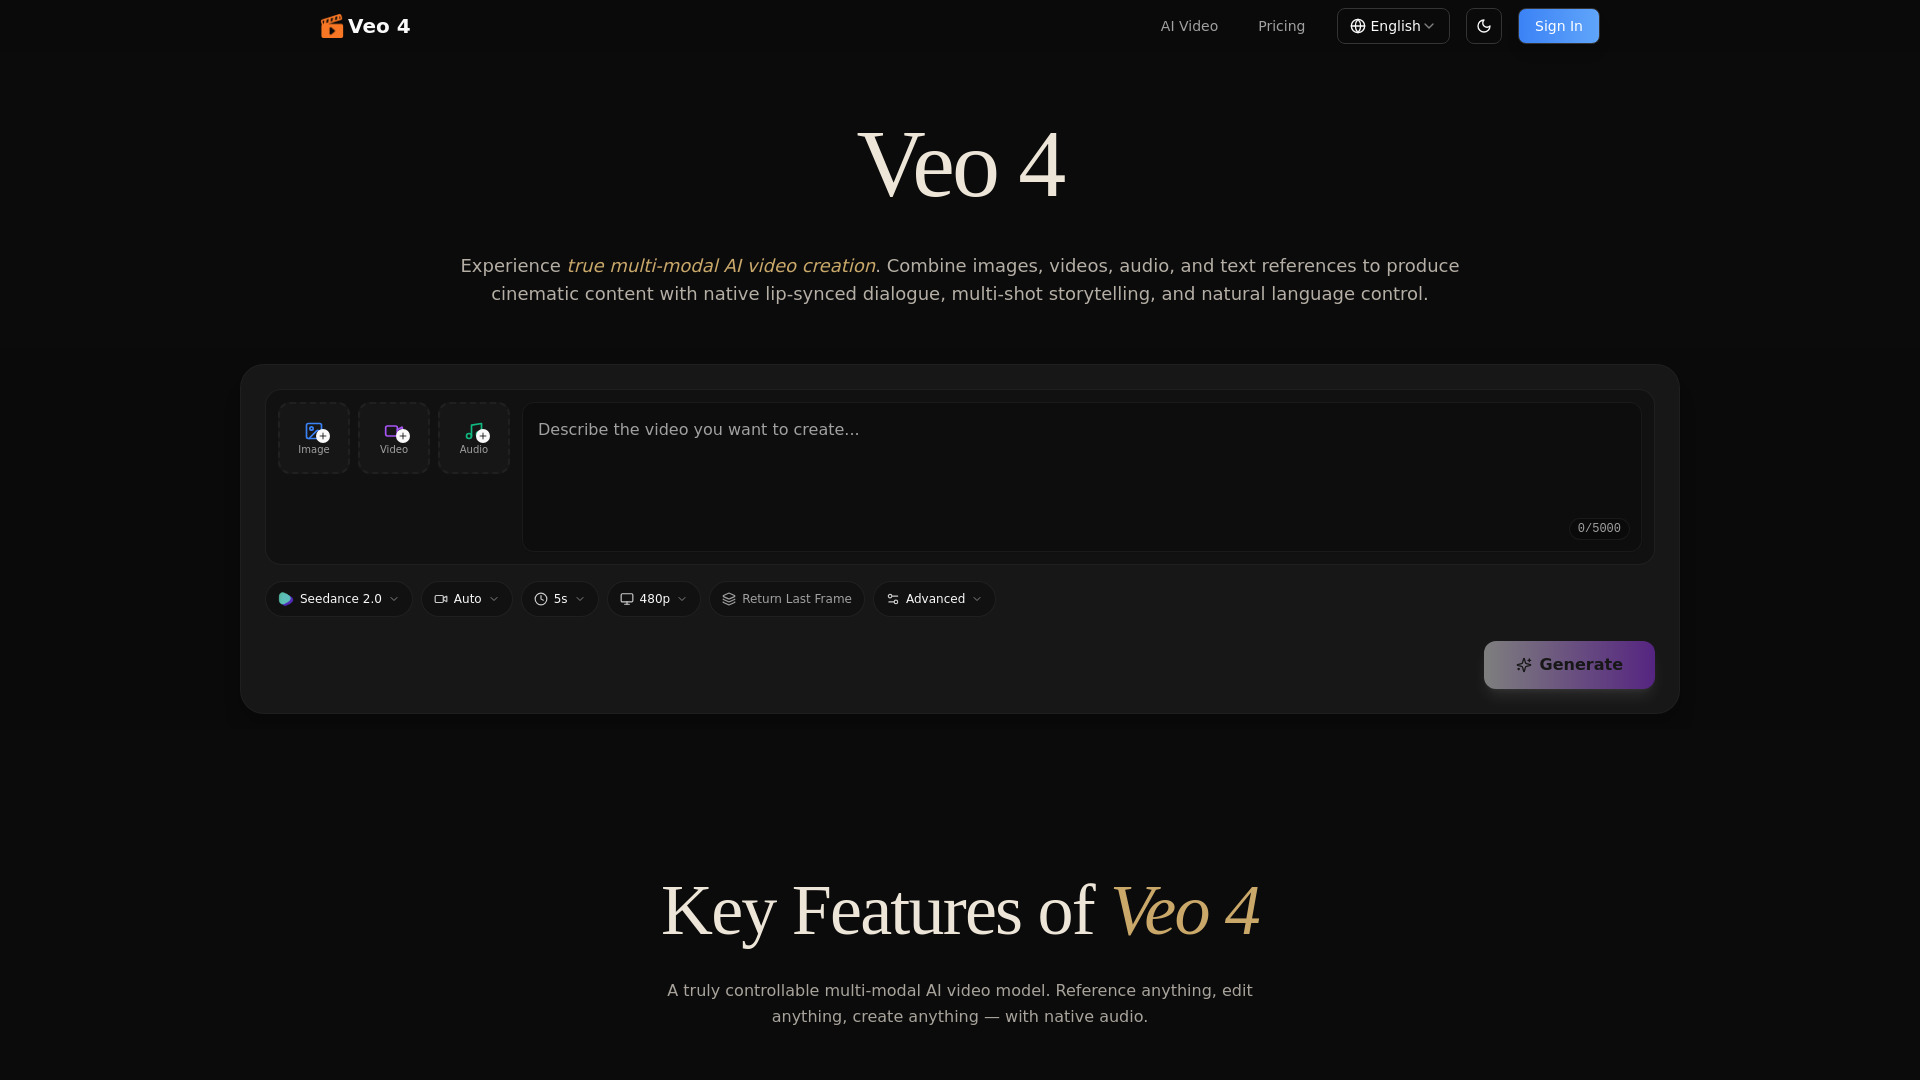
Veo 4 是下一代多模态 AI 视频生成模型,允许创作者通过结合文本、图像、视频和音频来生成电影级视频。与传统的 AI 视频工具不同,Veo 4 支持真正的多模态输入,使用户能够参考上传文件中的动作、运镜、角色和声音,从而制作出连贯的多镜头故事。它具备原生的音频生成能力,包括对口型对话和音效(Foley),并在 4 到 15 秒的镜头序列中保持面部、服装和风格的高度视觉一致性。它还提供先进的视频编辑功能,例如延长现有剪辑以及替换场景中的特定角色或元素。
适合人群
- 内容创作者
- 电影制作人
- 营销专业人士
- 社交媒体运营
- 视频剪辑师
- 数字艺术家
- 动态设计师
产品优势
- 跨多镜头的卓越角色和风格一致性
- 包含原生同步音频的全能生成体验
- 引用资源的自然语言控制方式高度直观
- 支持多种宽高比和屏幕方向(横屏和竖屏)
- 专业输出结果无水印
使用注意
- 单段镜头最长限时 15 秒
- 处理复杂的多资产参考可能需要多次迭代
 美国
 印度