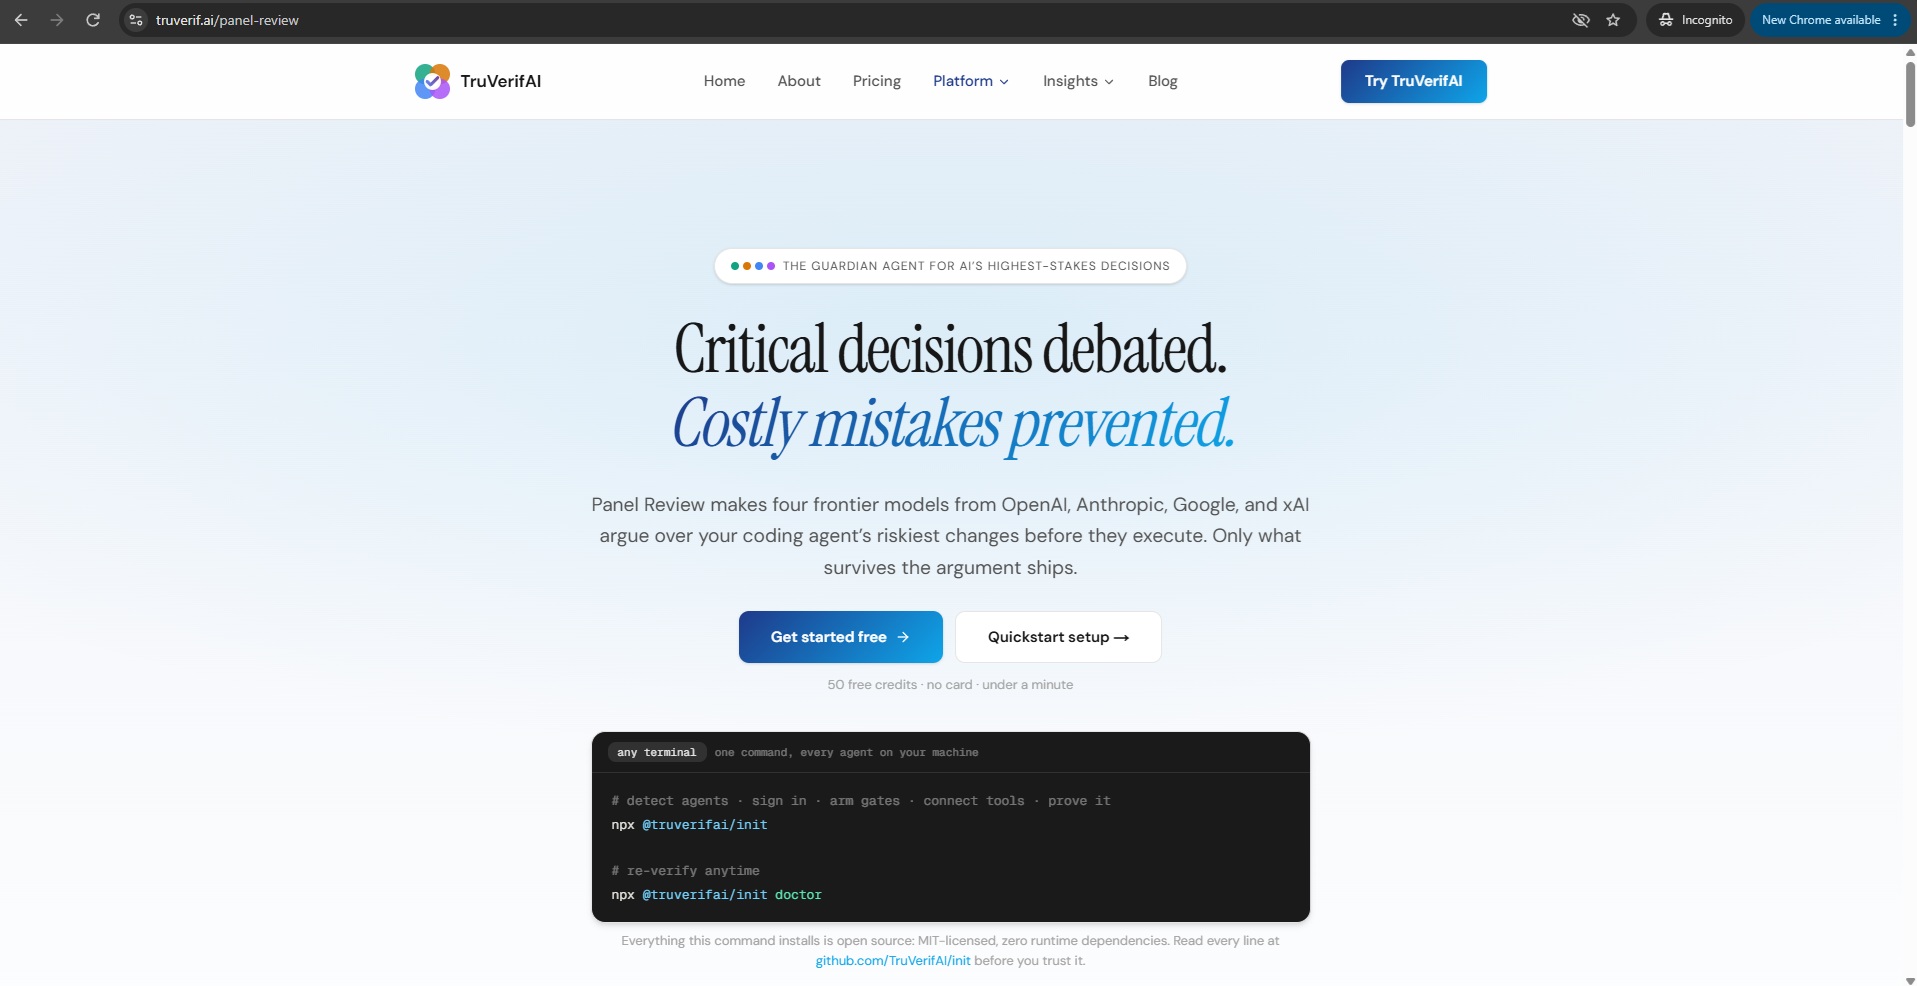
核心功能与独特优势:评审门在代理循环内部触发,在高风险写入或提交之前运行,代理无法静默跳过;始终覆盖十三类不可妥协的风险类别(包括密钥、支付代码、被删除的安全控制措施等),同时支持为你的代码库定义自定义风险阈值;由四家厂商的模型进行交叉质询,而不是让一个模型评审同一模型家族的输出;客户端采用 MIT 开源许可证、零依赖,并可通过 npx 在不到一分钟内完成安装。
适用人群:使用 Claude Code、Cursor、Codex CLI、Copilot 和 Gemini CLI 等 AI 编程代理的开发者,包括个人开发者、快速原型开发者和小型 IT 团队。
能为用户做什么:捕获 AI 编写代码最容易遗漏并最终上线的错误。在十周的生产环境使用中,46% 的审计发现了至少一个严重或重大问题,66% 的实际评审调用改变了代理接下来的操作。采用积分计费:终身免费赠送 50 积分,之后提供每月 12 美元或 30 美元的方案。
安装:https://truverif.ai/settings/mcp#setup
安装 [不到一分钟、赠送 50 个免费积分、完全可撤销]:npx @truverifai/init
适合人群
- 研究人员
- 记者
- 事实核查人员
- 内容策略师
- 法律专业人士
- 学术研究人员
- 分析师
产品优势
- 使用多个顶尖 AI 模型来减少偏差并提高完整性。
- 专用模式通过模型协同讨论显著提高准确率并减少幻觉。
- Verify 模式提供透明证据、网络验证和可引用的来源。
- 付费方案中未使用的积分可结转至下个月。
- 提供额度充足的免费起始积分。
使用注意
- 高准确率模式(Justify 和 Verify)速度明显更慢(最长可达 150 秒),成本也更高(最高为普通模式的 4 倍)。
- 免费积分为一次性赠送。