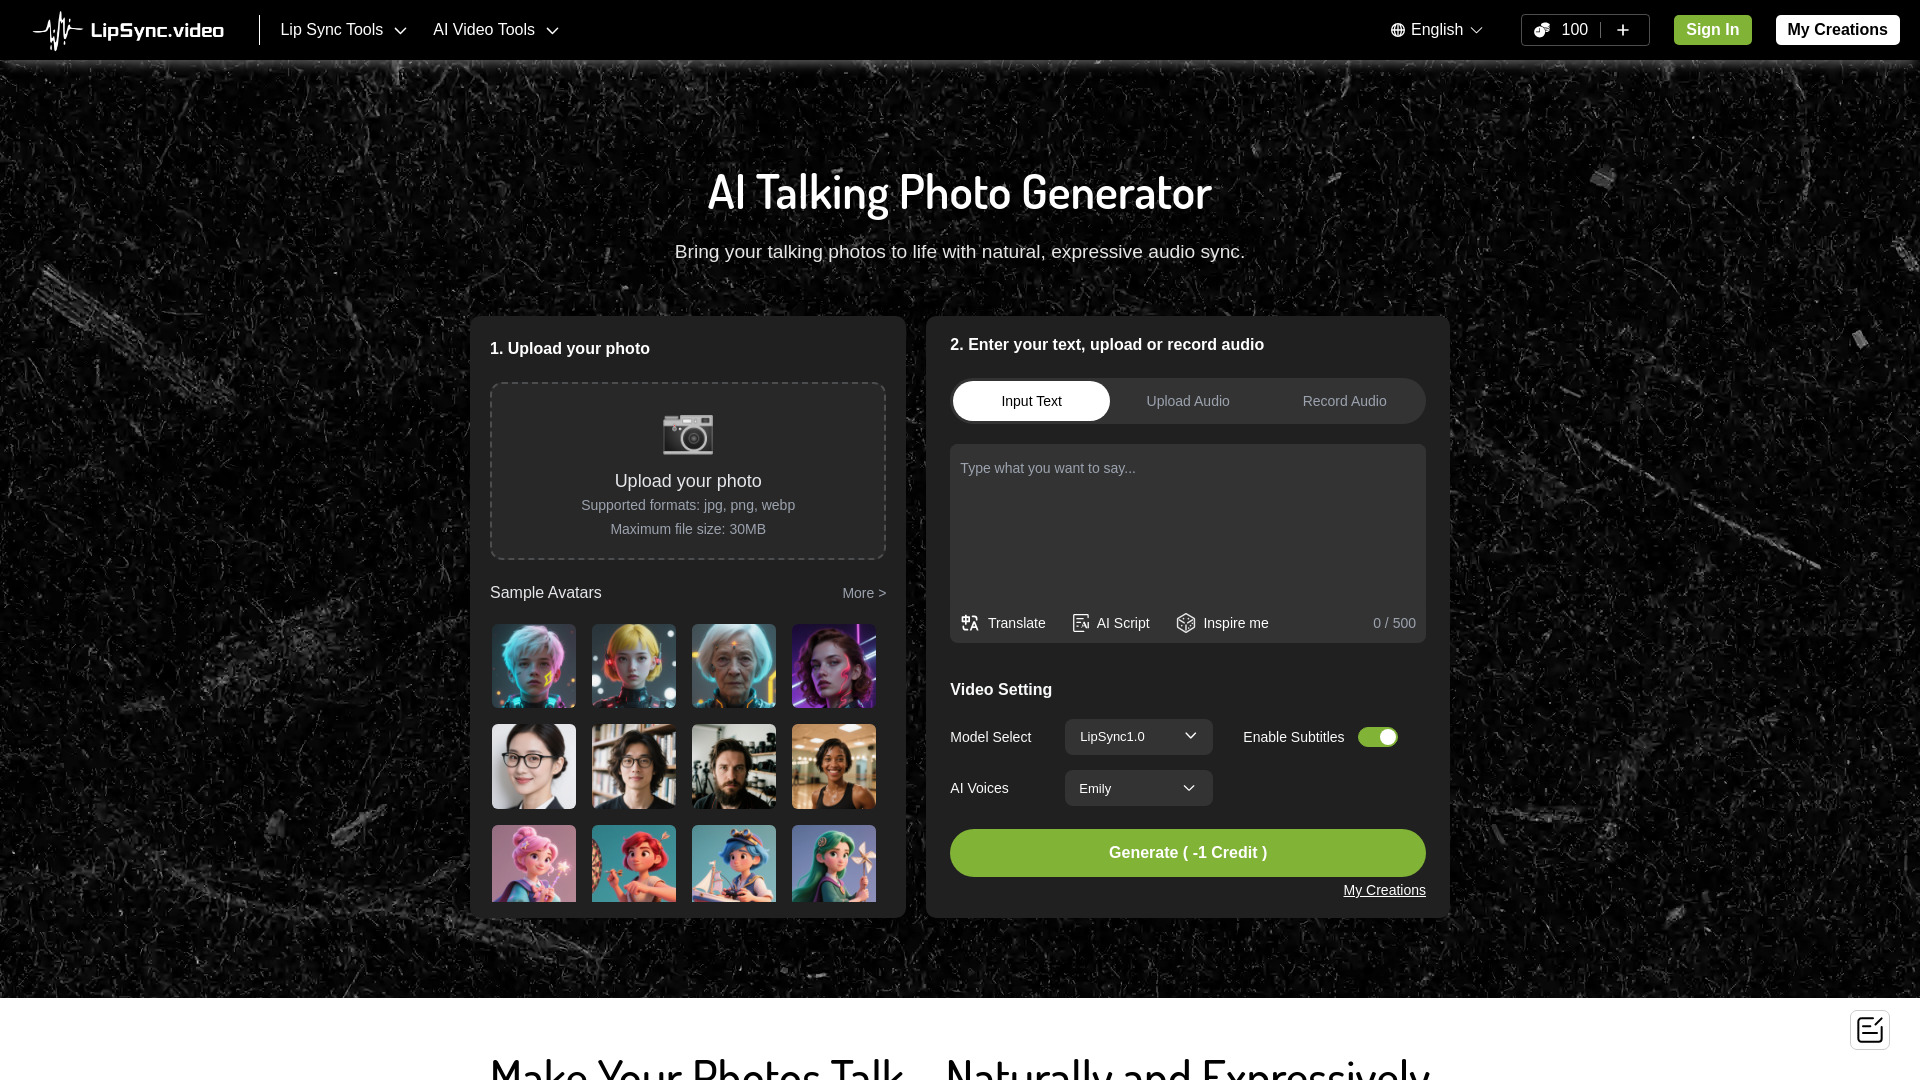
AI说话照片生成器是一项利用人工智能技术对静态照片进行动画处理的技术,使其看起来能够自然地说话。它通过分析面部特征,将照片转换为逼真的说话动画,创建与音频输入同步的真实唇部运动和面部表情,从而提供自然且富有表现力的效果。
适合人群
- 内容创作者
- 营销专业人士
- 教育工作者
- 在线学习开发者
- 活动组织者
- 博物馆策展人
- 旅游局
- 社交媒体经理
- 数字艺术家
产品优势
- 将照片转变为极其逼真的说话动画,具有自然且富有表现力的音频同步
- 利用先进的AI技术实现令人惊叹的专业效果
- 生成视频的简单3步流程(上传、添加音频、生成)
- 支持多种音频输入方式(文本转语音、上传、录音)和格式
- 允许在商业上使用生成的说话照片
- 提供不同的LipSync模型,优化质量和速度
使用注意
- 严格的图像要求(单一、清晰、正面朝向的面部,光线良好)
- 基于音频输入的最大视频长度限制为90秒
- 基于积分的系统限制了可以创建的视频数量
- 照片上传大小限制为30MB
 美国
 德国