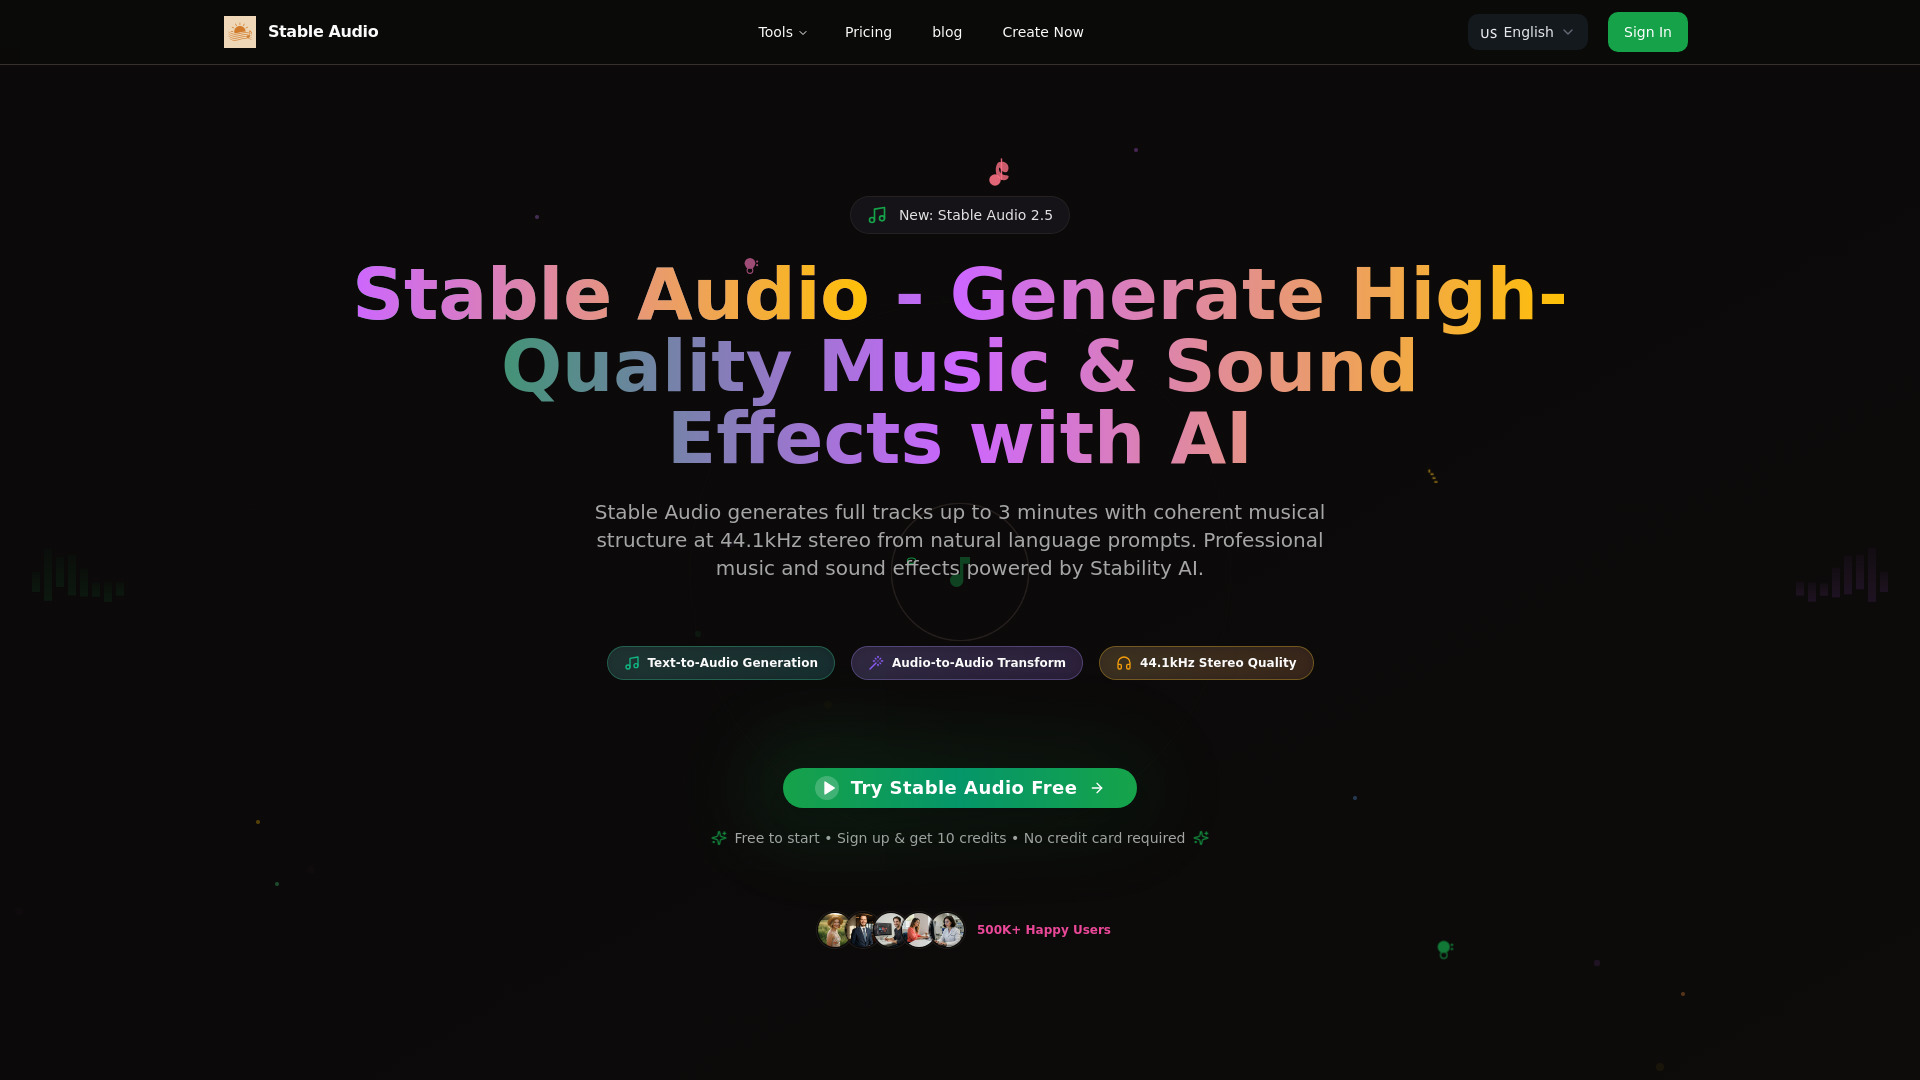
稳定音频是由稳定性人工智能提供支持的先进人工智能模型,旨在生成高质量的音乐和音效。它可以根据自然语言提示创建最长3分钟的完全曲目,具有连贯的音乐结构,以44.1kHz立体声输出。该平台提供文本到音频生成和音频到音频转换功能,生成适合商业用途和内容创作的广播级音频。支持50多种音乐风格和流派,包括流派融合和基于情绪的生成,具有先进的人工智能智能,理解音乐理论、情感背景和专业歌曲结构(前奏、主歌、副歌、桥段、尾声)。所有生成的音乐都是100%免版税的,附带完整的商业许可。
适合人群
- 音乐制作人
- 播客主持人
- 电影制作人
- 市场总监
- 内容创作者
- 活动策划人
- 游戏开发者
- 独立音乐人
- 创意总监
- 音乐教师
产品优势
- 生成高质量、适合广播的音乐和音效。
- 快速生成完整歌曲(在60秒以内)。
- 100%免版税,附带完整商业许可。
- 无需音乐经验,处理技术细节。
- 多种风格和流派(50多种)、流派融合和基于情绪的生成。
- 高级AI理解音乐理论、情感背景和专业歌曲结构。
- 提供文本到音频和音频到音频转换功能。
- 支持多种下载格式(WAV、MP3、MIDI)。
- 跨平台兼容(桌面、平板、移动)。
- 无限再生成可选变体。
- 注册即可免费开始获得10个积分。
使用注意
- 免费用户受限于有限的积分(10个积分)且可能有较少的功能。
- 无损音质、音轨分离和MIDI编辑等高级功能仅对付费计划开放。
- 最佳结果可能需要详细而具体的文本提示。
 美国