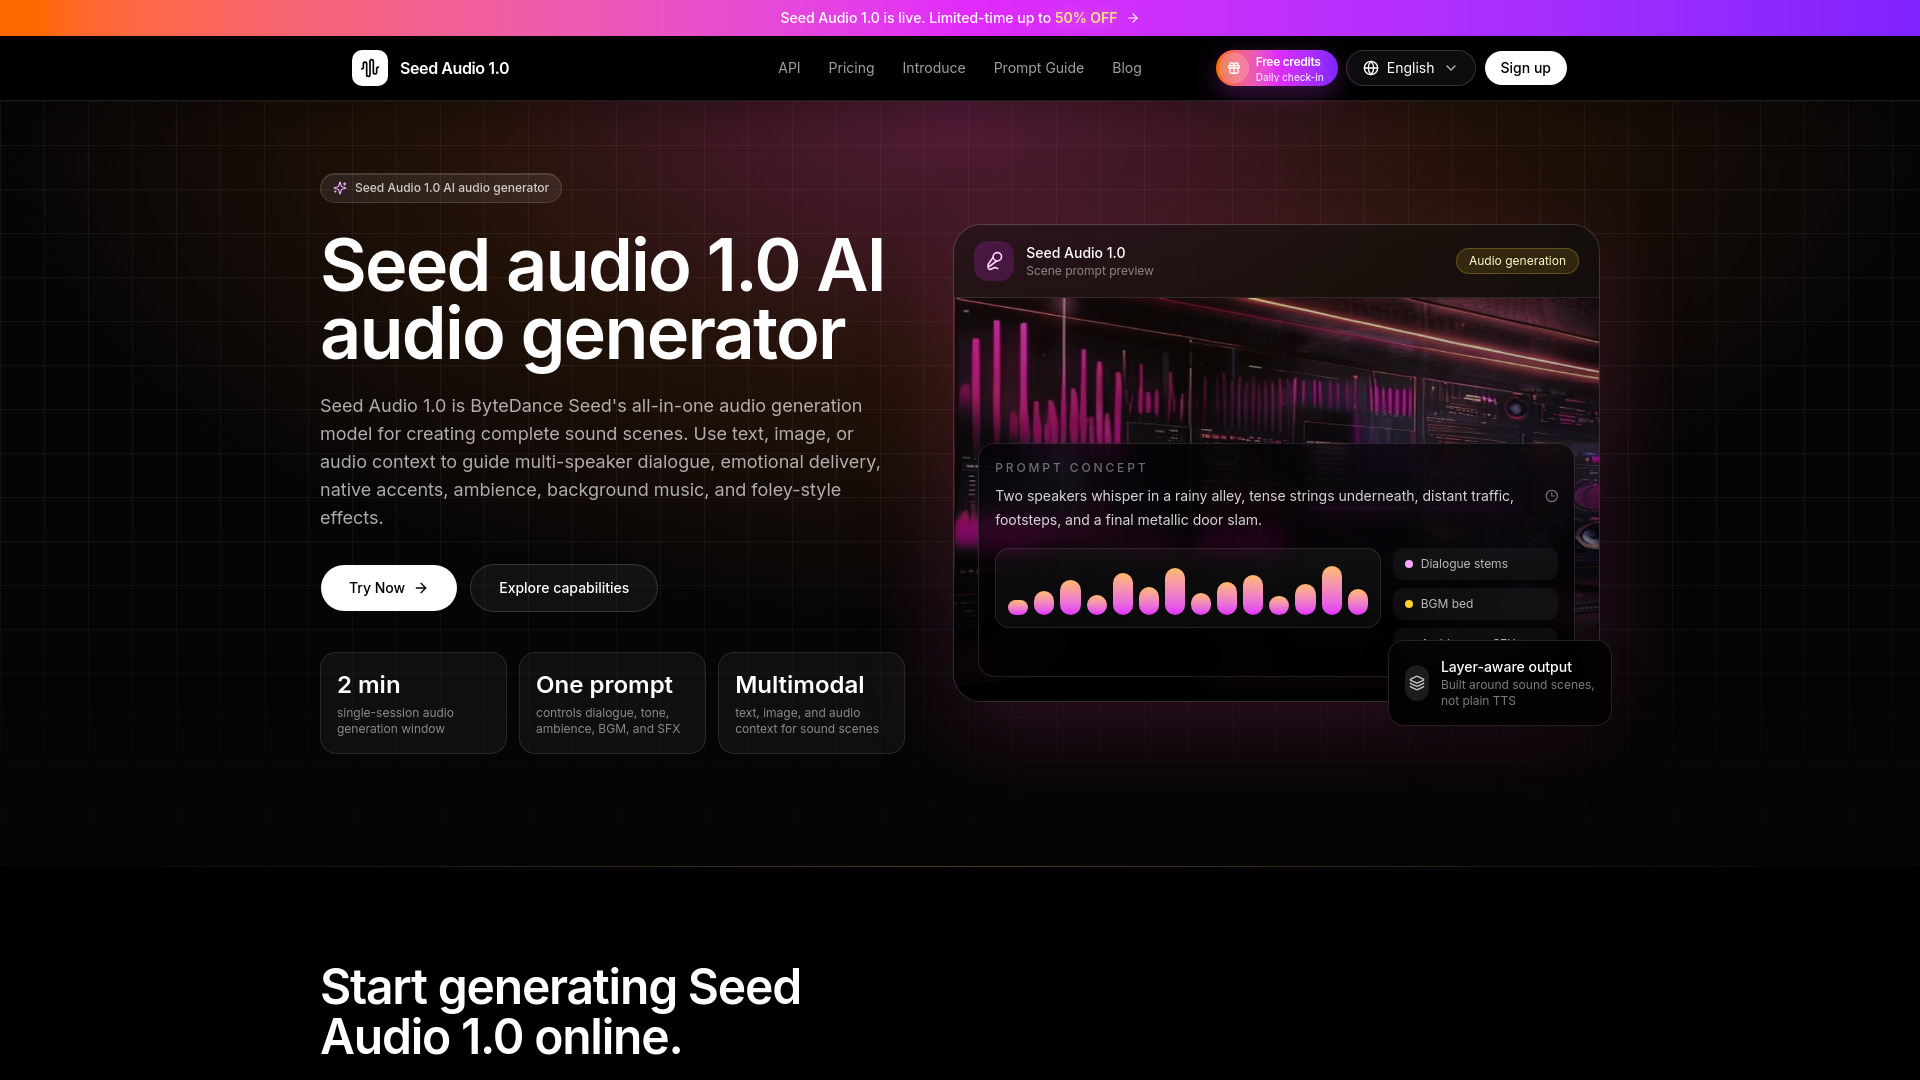
Seed Audio 1.0 是字节跳动 Seed 推出的多模态 AI 音频生成模型,可根据文本、图像或音频参考创建完整的声音场景。它能够在单条提示词中生成多角色对话、情绪化表达、地道口音、环境氛围、背景音乐以及拟真拟音效果。该平台专为较长音频场景设计,并支持分层音频输出,适用于电影、广告、播客、游戏、教育和 XR 原型等创意项目。
适合人群
- 音频制作人
- 声音设计师
- 电影制作人
- 视频创作者
- 播客制作人
- 游戏开发者
- XR 开发者
- 广告从业者
- 教育工作者
- 营销团队
- 内容创作者
- 创意机构
产品优势
- 在同一套工作流中融合对白、音乐、环境音和音效生成
- 支持文本、图像和音频上下文
- 提供情绪表达、口音和声音表现控制
- 支持多角色场景和音色连贯性
- 通过共享积分余额提供网页端和 API 访问
- 注册即可获得免费积分用于测试
使用注意
- 免费套餐仅包含 10 积分,每次生成时长约为 8 秒
- 每次生成最长限制为 2 分钟
- 较长或高频率的项目需要购买付费积分
- 要获得最佳效果,可能需要编写详细的声音场景提示词
- 所提供的信息未明确说明商业使用条款
 美国