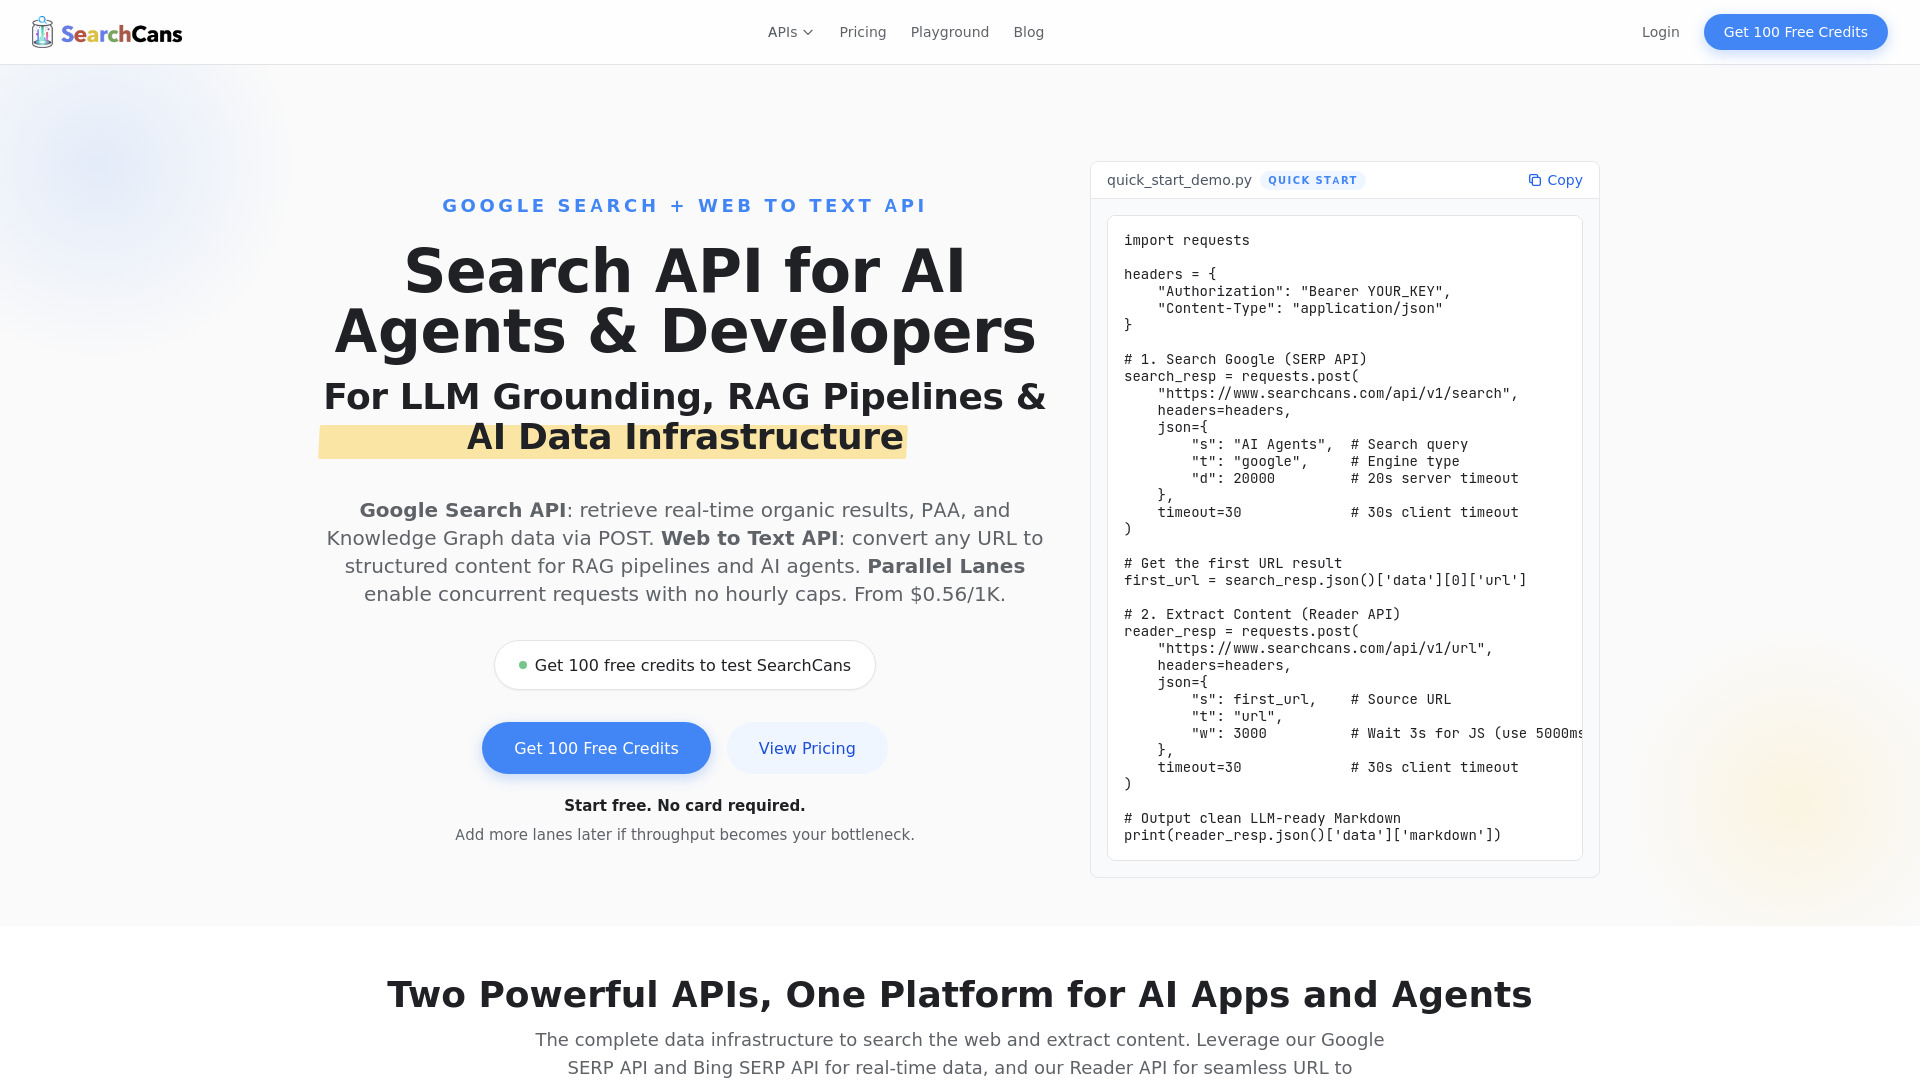
SearchCans 是一款专为自主 AI 智能体(Agents)、大语言模型(LLM)知识接地(Grounding)和高级检索增强生成(RAG)管道量身定制的下一代、高性能实时数据基础设施。它作为一个统一、极速的数据加油站,将全功能搜索引擎抓取与智能网页转文本 Markdown Reader 完美结合到了一个开发者优先的平台中。
我们的核心实时 API(生产级开箱即用):
1. 谷歌搜索 API(带丰富摘要)
一款高并发 API,旨在获取实时的谷歌搜索结果且绝不触发封禁。它返回结构化的 JSON 数据,包含自然搜索结果、知识图谱、People Also Ask(其他人还在问)问题、新闻和丰富摘要。非常适合让您的 AI 模型即时接入实时网络。
2. 必应搜索 API
提供来自必应生态系统的全面备用搜索索引。基于相同的高速并行架构构建,确保您的 AI 智能体具备冗余的、跨平台的实时网络验证能力。
3. 网页转文本 / Markdown Reader API
一款智能的网页抓取与解析引擎。只需输入任意 URL,API 就会渲染该页面(即使是重度 JavaScript/SPA 也不在话下)、绕过 Cloudflare、剔除追踪脚本、广告和臃肿的 HTML,并输出干净、高保真的 Markdown 文本。这是将数据直接喂给 LLM 和向量嵌入(Embeddings)的完美格式化工具。
为什么 AI 开发者选择 SearchCans 2.0:
1. 独家并行搜索通道:
传统的 SERP API 是十年前为 SEO 营销人员设计的,其严格的每小时频率限制严重阉割了多智能体工作流。SearchCans 引入了独特的并行处理架构。开发者可以在同一秒内执行数千个并发请求,支持企业级重度工作流的瞬间爆发,而不会触碰任何小时限流墙。
2. 先进的反爬虫与 JS 渲染绕过:
凭借优质的住宅代理池和隐身浏览器指纹技术,SearchCans 能够轻松绕过严厉的反爬虫墙(Cloudflare、DataDome、Akamai)。它能完全渲染基于 JavaScript 的重度单页应用(SPA),以提取出普通基础爬虫工具经常漏掉的隐藏文本内容。
开发者的理想应用场景:
- 自主 AI 智能体:非常适合作为 CrewAI、AutoGen 和 LangGraph 等需要实时网络上下文来进行决策的多智能体编排系统的完美中间件。
- RAG 知识库灌注:通过 LlamaIndex 或 LangChain 立即将干净、不限流的网页文本注入到向量数据库中。
- AI 搜索引擎与类 Perplexity 应用:利用低延迟、结构化的 SERP 数据构建自定义的实时搜索问答引擎。
颠覆性的按量计费模式:
我们讨厌“臃肿的包月订阅”。SearchCans 采用 100% 透明、按成功请求计费的额度模式,起步价低至每 1,000 次成功请求仅需 0.56 美元。没有月度套餐包袱,没有隐形费用,无需前期承诺。每个新注册的开发者账号在注册后都会立即获得 100 个免费测试额度——无需绑定信用卡。
适合人群
- AI 工程师
- 软件开发人员
- RAG 系统架构师
- 数据基础设施工程师
- AI 智能体开发人员
产品优势
- 并行执行通道无每小时频率限制
- 性价比极高,每 1,000 次请求仅 0.56 美元起
- 提供 100 个免费额度,无需信用卡即可测试
- 高可靠性,目标可用性(Uptime)达 99.99%
使用注意
- 预付费额度有效期仅为 6 months (6个月)
- 高级功能(如住宅代理绕过模式)会消耗数倍的额度
- 退款严格限制在 7 天内且额度使用量需小于 10%
 美国
 德国
 英国
 越南
 印度