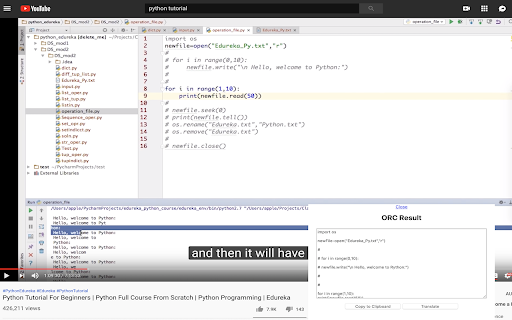
这是一个实用工具,可以通过一键操作从图像、视频或PDF中提取文本,而无需逐个字符地重新输入。常见的用例是在YouTube视频或图像格式教程中复制任何文本。此工具使用轻量级OCR引擎Tesseract.js从图像中提取文本。
适合人群
- 学生
- 研究人员
- 内容创作者
- 数据录入专业人士
- 需要从视觉源提取文本的任何人
产品优势
- 使用简单,一键提取
- 支持多种输入格式(图像、视频、PDF)
- 包含翻译功能
- 使用轻量级OCR引擎(Tesseract.js)
使用注意
- 准确性取决于输入图像/视频的质量
- 可能需要调整OCR语言设置以获得最佳结果