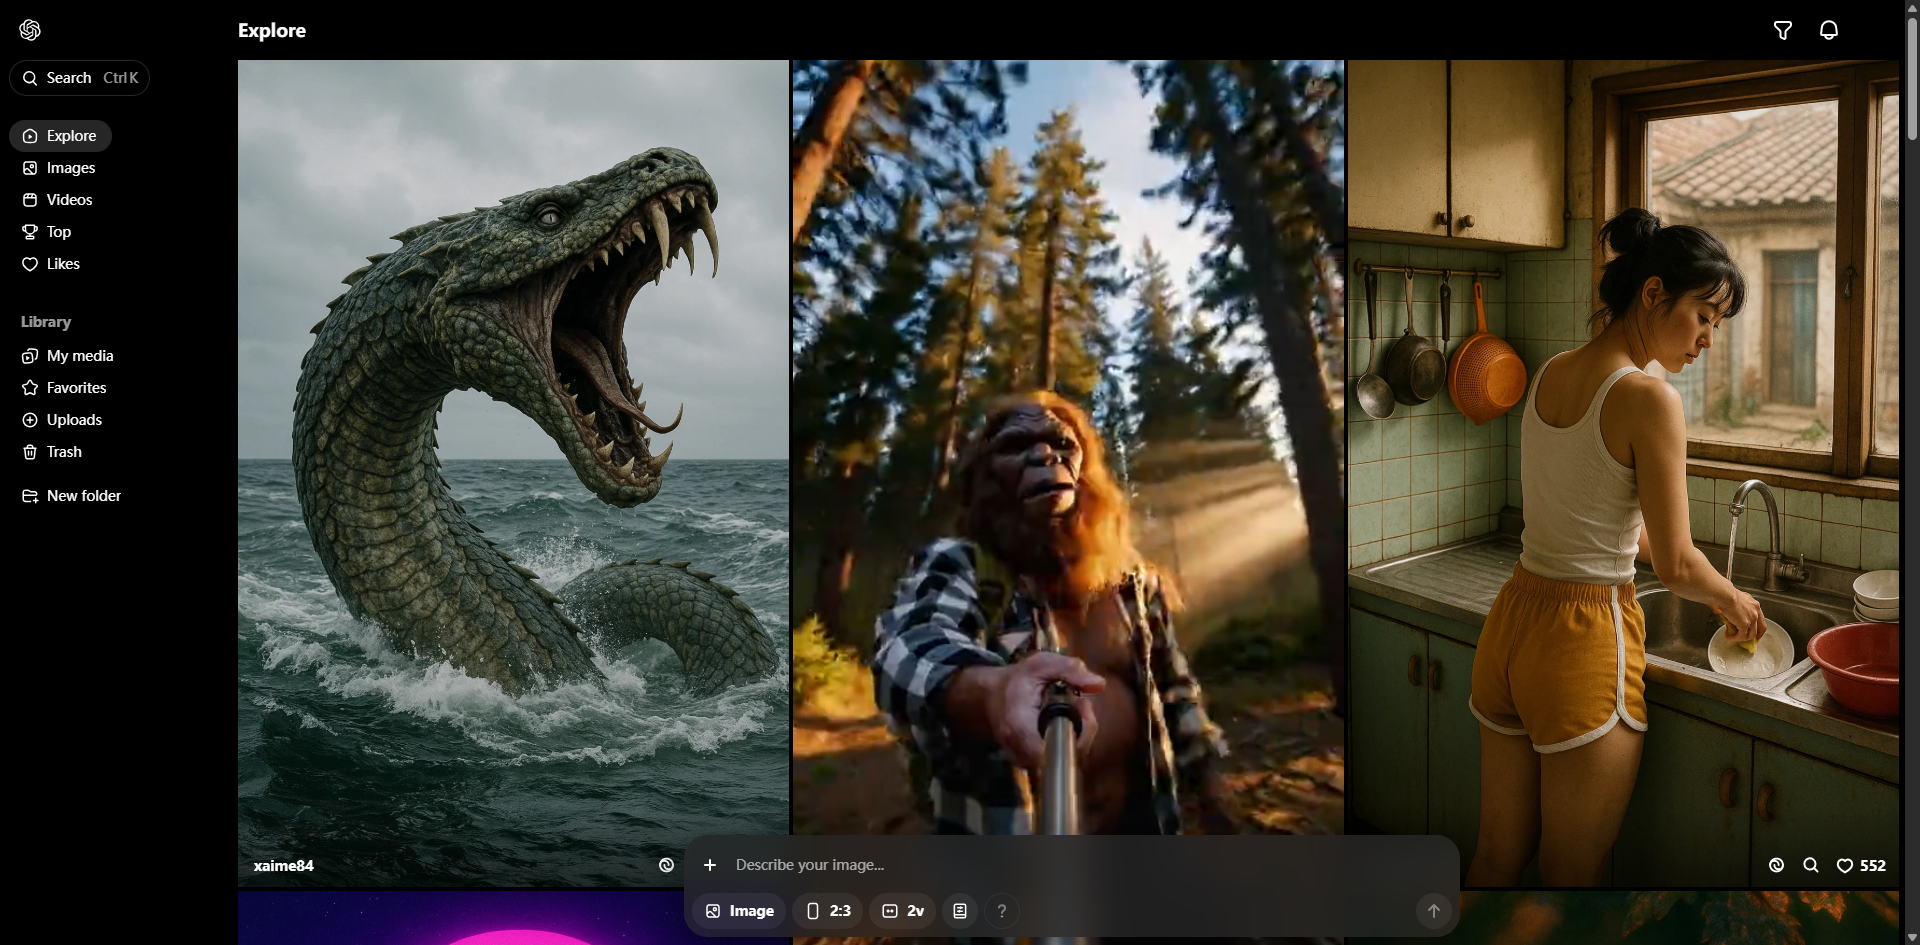
Sora是一个由OpenAI开发的AI模型,能够根据文本指令生成逼真和富有想象力的场景。它旨在理解和模拟动态的物理世界,生成时长最长为一分钟的视频,同时保持视觉质量和用户提示的准确性。Sora使用扩散模型和变换器架构,类似于GPT模型,使其能够生成包含多个角色、特定运动类型和准确细节的复杂场景。它还可以根据现有的静态图像生成视频,并扩展或填充现有视频的缺失帧。Sora旨在成为理解和模拟真实世界的模型的基础,是实现AGI的一步。
适合人群
- 视觉艺术家
- 设计师
- 电影制作人
- 创意专业人士
- 内容创建者
- 动画师
- 市场营销专业人士
- 红队成员(进行安全评估)
产品优势
- 生成高度逼真和富有想象力的视频。
- 能够生成最长为一分鐘的视频。
- 保持高视觉质量,并紧密遵循提示。
- 能够理解和模拟复杂的物理交互和运动。
- 能够生成包含多个角色和准确细节的复杂场景。
- 对语言的深刻理解以进行精准的提示解读。
- 确保角色和视觉风格在多个镜头中保持一致。
- 能够对静态图像进行动画处理和扩展现有视频。
- 利用变换器架构以获得更优的扩展性能。
使用注意
- 可能难以准确模拟复杂场景的物理状态。
- 可能无法理解特定的因果关系实例(例如:饼干被咬了一口后没有出现咬痕)。
- 可能混淆空间细节(例如:左右混淆)。
- 可能难以精确描述随时间推移发生的事件,或特定摄像机轨迹。
- 有时可能会创建物理上不合理的运动。
- 在包含许多实体的场景中,动物或人可能会自发出现。
- 可能出现不准确的物理建模和不自然的物体'变形'。
- 模拟对象之间的复杂交互和多个角色之间的互动存在挑战。
 美国