语音AI

Omnilingual Asr

使用AI和LLM增强解码器统一超过1600种语言的语音识别。

价格以官网为准编辑评分 未评分
访问官网 ↗

产品与联系信息

使用平台
网页版
语言支持
未注明
资料更新
2026-11-05
omnilingualasr.net
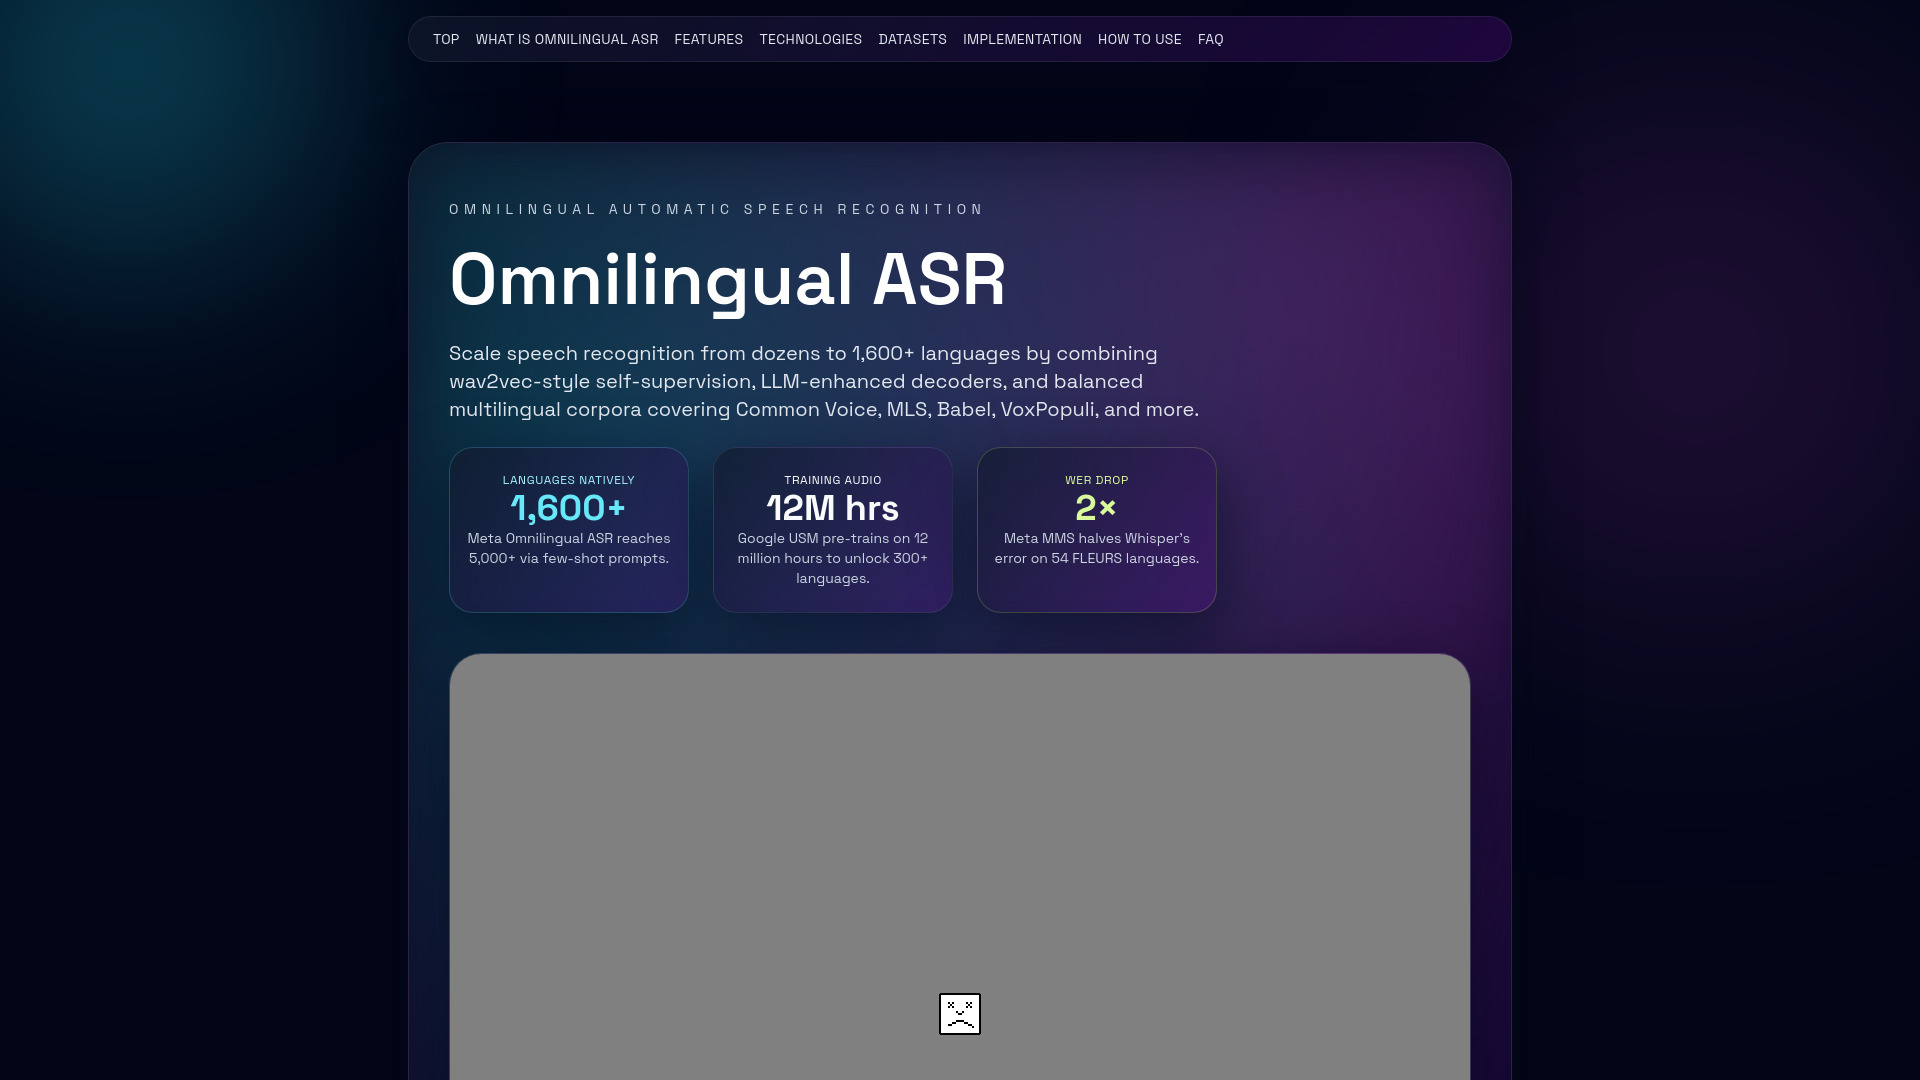
Omnilingual Asr 产品截图查看大图 ↗
Omnilingual Asr 产品截图图片来源 ↗产品页面预览

核心能力

6 项
  • 将语音识别扩展至1600种以上的母语(通过少量示例提示可达5000种)
  • 语言自适应编码器,为各种语言提供共享的语音表示
  • 使用LLM增强解码器生成语法丰富的文本和翻译
展开全部 6 项
  • 将语音识别扩展至1600种以上的母语(通过少量示例提示可达5000种)
  • 语言自适应编码器,为各种语言提供共享的语音表示
  • 使用LLM增强解码器生成语法丰富的文本和翻译
  • 集成语言识别以处理混合语言音频
  • 平衡的训练策略,缩小语言之间的字误率(WER)差距
  • 灵活部署为开源检查点或云API

典型使用场景

4 项
  • 在全球范围内部署单一的语音识别系统,降低运营成本。
  • 为低资源语言社区提供语音技术的接入。
  • 实现跨语言应用,如全球字幕生成、多语言助手或多语言通话分析。
展开全部 4 项
  • 在全球范围内部署单一的语音识别系统,降低运营成本。
  • 为低资源语言社区提供语音技术的接入。
  • 实现跨语言应用,如全球字幕生成、多语言助手或多语言通话分析。
  • 在从阿姆哈拉语到英语的多种语言中进行语音转录和翻译。

快速上手

1 项
  • 快速上手

    使用Omnilingual ASR时,首先定义目标语言和领域。然后,选择适当的基础模型(例如,Whisper、MMS或云API),并使用您的特定数据进行微调或通过API进行配置。集成语言识别以处理混合语言音频,部署系统,并持续监控其性能,借助反馈不断迭代改进。

查看完整说明
  • 快速上手

    使用Omnilingual ASR时,首先定义目标语言和领域。然后,选择适当的基础模型(例如,Whisper、MMS或云API),并使用您的特定数据进行微调或通过API进行配置。集成语言识别以处理混合语言音频,部署系统,并持续监控其性能,借助反馈不断迭代改进。

工具详细介绍进一步了解 Omnilingual Asr 的产品定位与使用说明展开阅读收起介绍

Omnilingual ASR是一种先进的自动语音识别技术,它统一了超过1600种语言的语音识别能力,利用少量示例的提示可扩展至5000种语言。它通过结合wav2vec风格的自我监督、增强的LLM解码器以及平衡的多语言语料库来学习语言无关的声学模式。该网站作为一个全面的知识库,详细介绍了其研究突破、当前技术、数据集、实施策略和部署指导,以实现单一模型的通用语言覆盖。

适合人群

  • 人工智能/机器学习研究人员
  • 软件开发人员
  • 全球企业
  • 内容创作者
  • 语言保护者
  • 云服务提供商
  • 数据科学家
  • 产品经理

产品优势

  • 将语音识别扩展至1600多种母语和5000多种通过少量示例提示的语言。
  • 通过使用单一的部署来降低多个语言的运营成本。
  • 为低资源社区提供语音技术的接入。
  • 实现先进的跨语言应用,如全球字幕生成和多语言助手。
  • 提供包括开源模型和云API在内的灵活部署选项。
  • 与之前的模型相比,显著降低字误率(WER)。
  • 支持通过少量示例扩展能力,以最小数据添加新语言。
  • 包括集成的语言识别能力。

使用注意

  • 某些低资源语言的字误率(WER)仍然可以很高(如:谷歌USM报告超过30%)。
  • 解码器过度依赖语言先验可能导致幻觉现象。
  • 训练期间需仔细平衡数据以防止英语主导。
  • 虽然支持少量示例,但更多标注音频提升新增语言的字符错误率(CER)稳定性。
  • 专有云API涉及基于使用的定价和特定的数据治理条款。
产品表现洞察

Omnilingual Asr 数据分析

官网访问趋势、地区分布与流量渠道

更新于 2026-11-05

最新流量情况

月访问量 (2026-09)
暂无数据
平均访问时长
00:00:00
每次访问页数
0.00
跳出率
0.00%

访问量采用最近明确月份的曲线值;其余指标按概览区间展示。

2025-08 - 2026-09 全部流量

访客国家与地区

0 个地区

来源未标注统计范围

暂无公开地区数据

流量来源渠道

0 个渠道

来源未标注统计范围

暂无公开渠道数据

热门搜索关键词

公开搜索表现

暂无公开关键词数据

常见问题

10 个问题
通用语言ASR与多语言ASR有什么区别?

通用语言ASR通过共享编码器和语言无关的解码器同时针对所有语言,而多语言模型通常支持有限的子集(例如20至100种语言)。

当前哪些模型在通用语言ASR的准确性上领先?

Meta的MMS和通用语言ASR在长尾语言上提供最低的字误率(WER),而Whisper仍然是一个多功能的开放基线,谷歌的USM在专有服务中领先。

通用语言ASR可以自动检测语言吗?

可以。Whisper输出一个语言标记,MMS配备了一个4k语言的语言识别模型,而AWS/谷歌API在用户提供的候选集中执行自动检测。

添加新语言需要多少数据?

OmniASR通过几小时的标注音频或甚至少量示例进行适应,得益于通用编码器。更多的数据可提升字符错误率(CER)稳定性。

通用语言ASR支持翻译吗?

支持。Whisper经过训练可进行转录和翻译,OmniASR的LLM解码器可以输出目标语言文本,从而实现语音到文本的翻译工作流。

流式处理如何处理?

谷歌、微软、Deepgram和AWS等供应商提供由Conformer-Transducers或优化序列到序列模型支持的流式端点,而开放模型可以通过滑动窗口进行分块。

关于幻觉现象怎么办?

幻觉现象发生在解码器过度依赖语言先验时。解决方案包括约束解码、集成置信度阈值,或使用增强变体,如Gladia的Whisper-Zero,经过150万小时真实音频的训练。

有没有许可限制?

Whisper(MIT)和MMS/OmniASR(Apache-2.0)许可商业使用并要求归属,而云API包括基于使用量的定价和数据治理条款。

如何公正地评估通用语言ASR?

使用像FLEURS、Babel和MLS这样的平衡基准,报告按语言的字误率(WER)、宏平均,并突出低资源结果,而不是单一的汇总指标。

未来有哪些趋势将影响通用语言ASR?

预计将有更紧密的LLM-ASR融合(例如,GPT-4o风格模型)、混合专家编码器,以及community-sourced语料库推进覆盖面超过5000种语言。

评论与评分

总评分
请选择

正在载入评论…

真实会员评论,审核通过后公开展示。回复不重复计入评分。

探索更多相关工具

更多同类工具

音频AI

ElevenLabs

★ 4.6

知名 AI 语音生成平台,支持多语言配音与声音克隆。

高质量语音生成了解详情 →
视频AI

toklab

一个 API 接入各类 AI 模型,按量付费,价格透明。

了解详情 →
语音AI

Triggs AI

Triggs AI将WhatsApp变成一个类似于JARVIS的助手,以控制Alexa和自动化例程。

了解详情 →

安全验证

请完成验证后继续操作。