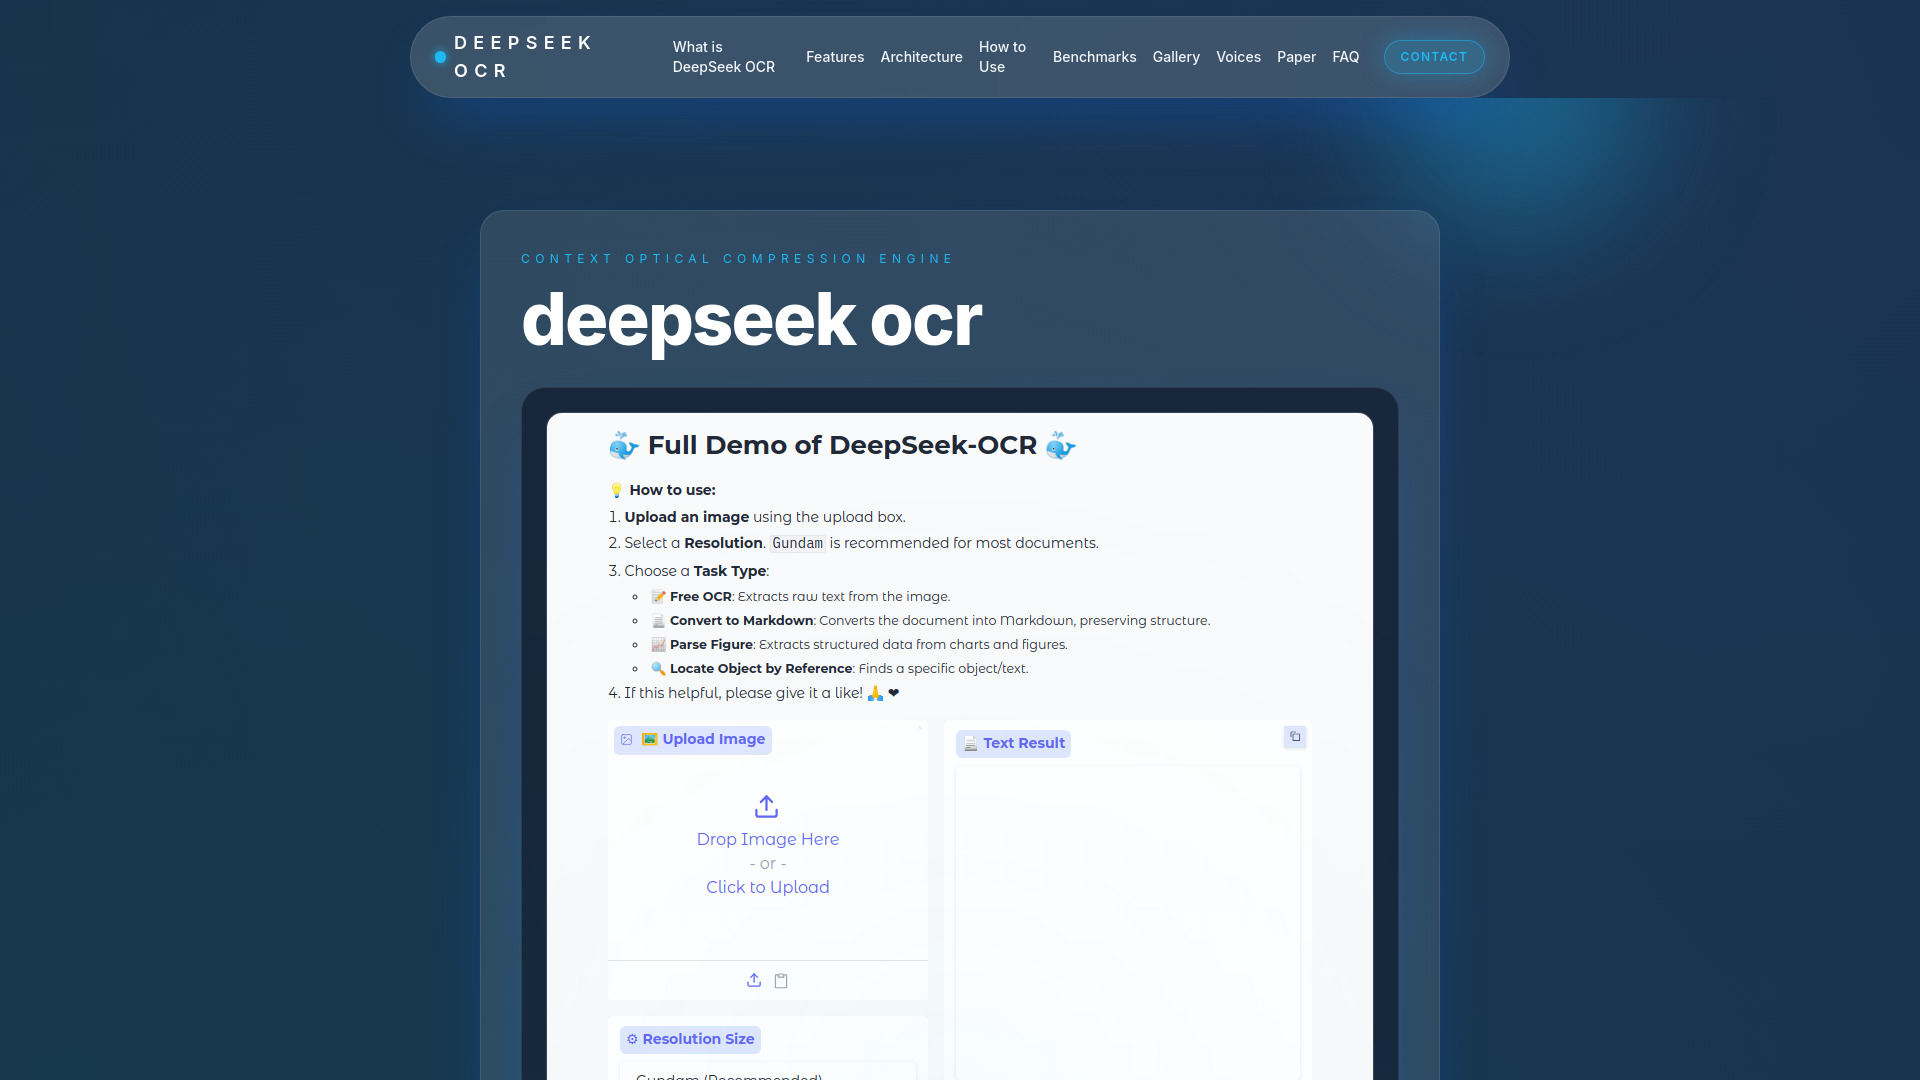
DeepSeek OCR 是一个基于两阶段变换器的文档人工智能系统,利用上下文光学压缩技术提供一流的文档智能。它将高分辨率文档压缩为精简的视觉标记,然后借助 30 亿参数的专家混合模型进行解码,实现对 100 多种语言几乎无损的文本、布局和图表理解。支持在复杂布局下进行 GPU 高效处理,并在 3000 万个真实 PDF 页面和合成数据上训练,能够保留布局结构、表格、化学(SMILES 字符串)以及几何任务。
适合人群
- 开发者
- 数据科学家
- 企业
- 研究人员
- 有严格合规要求的组织
- 化学信息学专业人士
- 工程师
- 需要多语言数据集的内容创作者
产品优势
- 一流的准确率(97% 的精确匹配率在 10 倍压缩下)。
- 高吞吐量(每台 NVIDIA A100 GPU 每天约 20 万页)。
- 广泛的多语言覆盖(100 多种语言)。
- 生成结构化输出(HTML、Markdown、SMILES、JSON)。
- 上下文光学压缩减少了长文档的计算要求。
- 开源(MIT 许可)适合本地部署和合规控制。
- 保留布局结构、表格、化学和多模态能力。
使用注意
- 在高压缩比下准确度显著下降(在 20 倍时约 60%)。
- 对于细节矢量图形存在挑战;可能需要矢量自然解析器。
- 与专用工具相比在手写识别上的表现有限。
- 实时吞吐量需要现代 GPU。
- API 使用可能涉及对 DeepSeek 中国基础设施的监管审查。
 美国