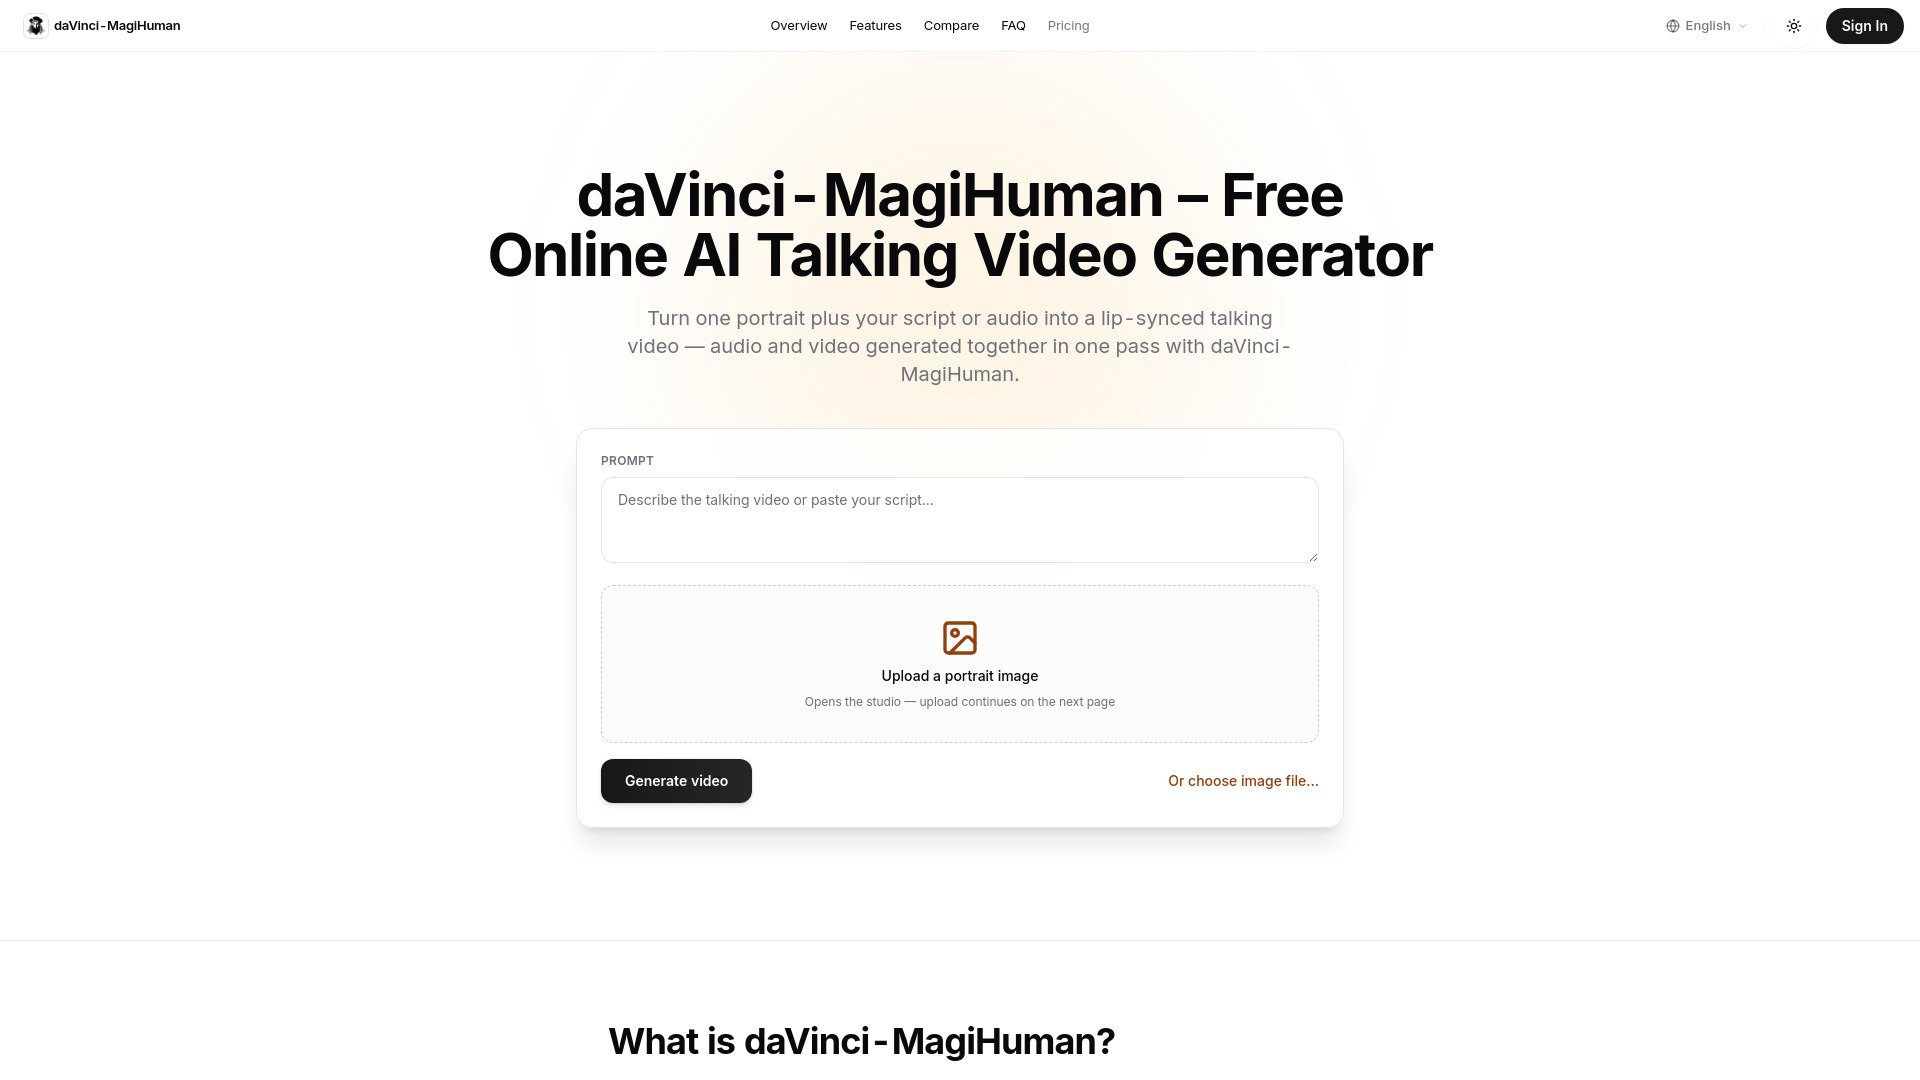
daVinci-MagiHuman 是一款由上海交通大学 Sand.ai 和 GAIR 实验室开发的先进开源 15B 参数 AI 模型。它旨在通过单张人像照片和脚本或音频文件生成高质量、口型同步的数字人视频。与结合独立文本转语音(TTS)和视频流水线的传统方法不同,daVinci-MagiHuman 采用统一的单流 Transformer 架构,同时对视频和音频 Token 进行协同去噪。该模型基于 Apache 2.0 协议发布,允许用户检查权重、在本地运行推理,并将该技术用于商业用途。它针对速度进行了优化,在 NVIDIA H100 等专业级硬件上仅需几秒钟即可生成短视频剪辑。
适合人群
- 内容创作者
- 营销团队
- AI 开发者
- 数字艺术家
- 教育工作者
- 社交媒体网红
产品优势
- 开源权重确保了完全的透明度,并支持本地托管
- 统一的模型架构确保了完美的音画同步
- 宽松的 Apache 2.0 协议支持商业用途
- 在高端硬件上具有极高的处理速度
- 与常见基准模型相比,具有更卓越的口型同步准确度
使用注意
- 需要高端 GPU 硬件(如 H100)以获得最佳吞吐量
- 输出质量高度依赖于输入人像照片的质量
- 在线托管版本针对高分辨率生成采用积分额度制